
ChatGPTに質問すると、まるで人間と会話しているような文章が返ってくる。
Claudeに長い資料を渡せば、内容を整理して要約してくれる。
Geminiにアイデアを求めれば、数秒で複数の案を提示してくれる。
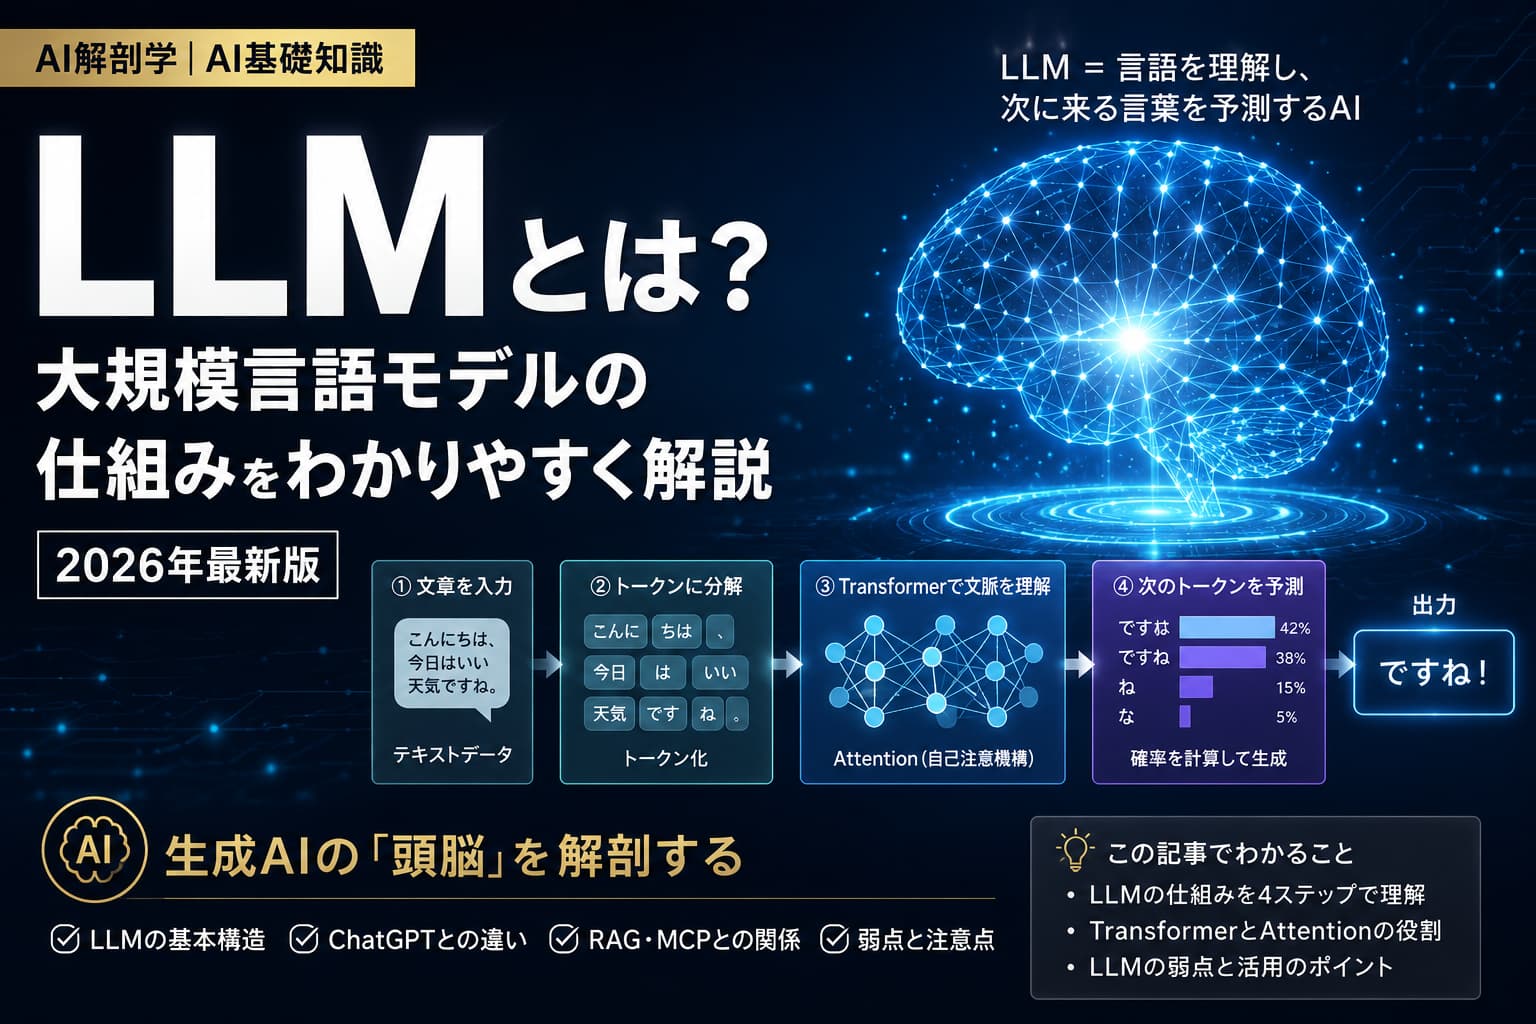
こうした生成AIの中核にある技術が、LLM(Large Language Model:大規模言語モデル)です。
しかし、
「LLMとChatGPTは何が違うのか」 「AIは本当に文章の意味を理解しているのか」 「なぜあれほど自然な文章を書けるのか」
と聞かれると、意外と説明するのは難しいものです。
この記事では、LLMの仕組みをできるだけ専門用語を減らして「構造」から解剖していきます。
LLMとは?
LLMとは、
Large Language Model(大規模言語モデル)
の略称です。
大量のデータから言語のパターンを学習し、文章の生成・要約・翻訳・質問応答などを行えるAIモデルを指します。
Googleは言語モデルについて、長いトークン列の中で「あるトークンやトークン列が現れる確率を推定するもの」と説明しています。現在のLLMでは、Transformerと呼ばれるアーキテクチャが広く使われています。
非常に単純化すると、LLMが行っていることは、
「ここまでの文章を見たとき、次に何が来る可能性が高いか?」
を予測することです。
例えば、
「日本の首都は」
という文章が入力されたとします。
するとモデルは学習してきたパターンから、
「東京」
が続く可能性が高いと予測します。
さらにその次、そのまた次と予測を繰り返すことで、長い文章を生成していきます。
つまりLLMは、巨大な「次に来る言葉の予測装置」と考えると理解しやすいでしょう。IBMもLLMを、大量のデータで訓練され、自然言語などを理解・生成できるディープラーニングモデルとして説明しています。
LLMを「言語中枢」で例えると分かりやすい
AI解剖学では、LLMを人間の脳の中にある「言語中枢(言語野)」として考えてみます。人間の脳には、言葉を理解したり話したりする働きを専門に担う部分があります。LLMも、AIという体全体の中で、言葉の処理だけを専門に担うパーツとイメージすると位置づけがはっきりします。
人間は長年の経験から、
「この状況なら、この言葉が自然だ」 「この質問なら、こう答えるべきだ」
という感覚を身につけます。
LLMも、大量の文章から言葉と言葉の関係を学習します。
ただし、人間の脳とLLMは同じものではありません。
LLMには生物学的な脳も、私たちと同じ意味での経験や感情もありません。
あくまで膨大な数値計算によって、入力された情報から適切そうな出力を生成するモデルです。
LLMの仕組みを4段階で解剖する
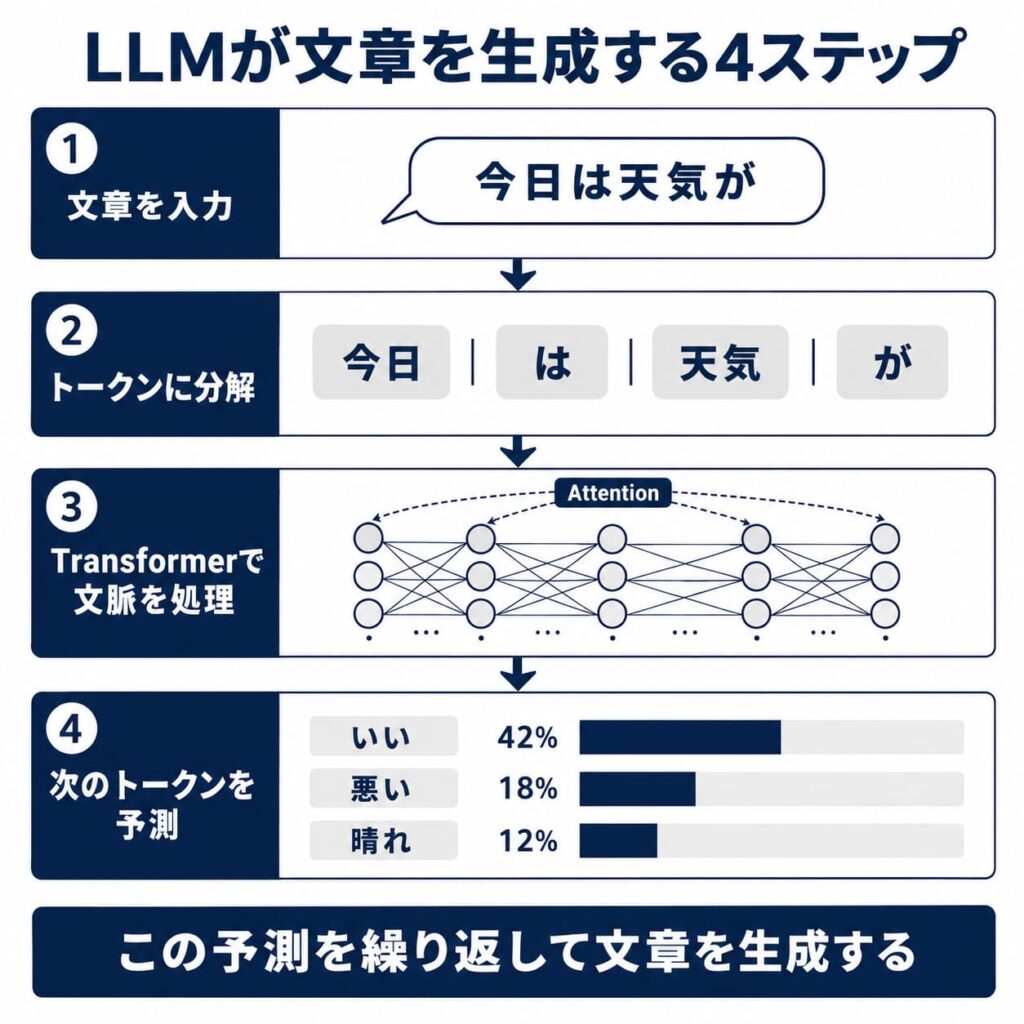
複雑に見えるLLMも、大きな流れに分けると理解しやすくなります。
文章 → トークン → Transformerで文脈を処理 → 次のトークンを予測
という流れです。
① 文章を「トークン」に分解する
LLMは文章をそのまま読んでいるわけではありません。
まず入力された文章をトークン(token)という単位に分解します。
トークンは単語そのものとは限らず、
- 1文字
- 単語の一部分
- 単語全体
- 句読点
などになる場合があります。
OpenAIも、トークンをモデルがテキストを処理する構成単位と説明しています。トークン化の方法はモデル・エンコーディング・言語によって異なります。
これが、ChatGPTなどでよく目にする「トークン数」の正体です。
② トークンを数字として扱う
コンピューターは「犬」「猫」「AI」といった言葉そのものを理解して計算しているわけではありません。
そこでトークンを数値表現へ変換します。
ここで重要になるのがEmbedding(埋め込み)です。
言葉やトークンを、多数の数字からなるベクトルとして表現します。
その結果、意味や使われ方が近いものを数値空間上で関連付けて扱えるようになります。
これが、LLMが単純な文字列一致を超えて言葉の関係を処理できる重要な土台です。
③ Transformerで文脈を読む
現代のLLMを理解するうえで非常に重要なのが、
Transformer(トランスフォーマー)
です。
Transformerでは、文章の中にある各要素の関係性を処理するためにAttention(注意機構)、特にSelf-Attentionが重要な役割を果たします。
例えば、
「美容院でかみを切った。」
という文章なら、「かみ」は「髪」を指すと自然に判断できます。
一方、
「工作の授業でかみを切った。」
という文章なら、同じ「かみ」でも今度は「紙」を指すと分かります。
このように、同じ言葉でも周囲の文脈によって意味が変わることがあります。LLMは単語だけを孤立して見るのではなく、周囲との関係を使って文脈を処理します。
Googleの説明でも、Self-Attentionが文脈上の意味を学習する重要な仕組みとして紹介されています。
④ 次のトークンを予測する
文脈を処理したら、次に来る可能性のあるトークンを予測します。
例えば、
「筋肉を大きくするには適切なトレーニングと」
まで入力されたとします。
続く候補として、
- 「栄養」
- 「休養」
- 「睡眠」
などにそれぞれ確率が与えられます。
そして選択されたトークンを文章に追加し、再び次のトークンを予測します。
これを高速で繰り返すことで、私たちから見ると「AIが文章を考えて書いている」ように見えるわけです。
なぜ「Large=大規模」なのか?
LLMの「Large」には、単純に文章が長いという意味があるわけではありません。
代表的なポイントは、
- 大量の学習データ
- 多数のパラメータ
- 広い文脈を扱う能力
です。
特に重要なのがパラメータです。
パラメータとは、学習によって調整されるモデル内部の数値です。
人間で例えるなら、学習によって形成された膨大な「結びつき」のようなもの、とイメージすると分かりやすいでしょう。
Googleも、大規模言語モデルが従来型の言語モデルより優れた予測を実現する要因として、多数のパラメータと、より多くのコンテキストを扱えることを挙げています。
LLMとChatGPTは何が違う?
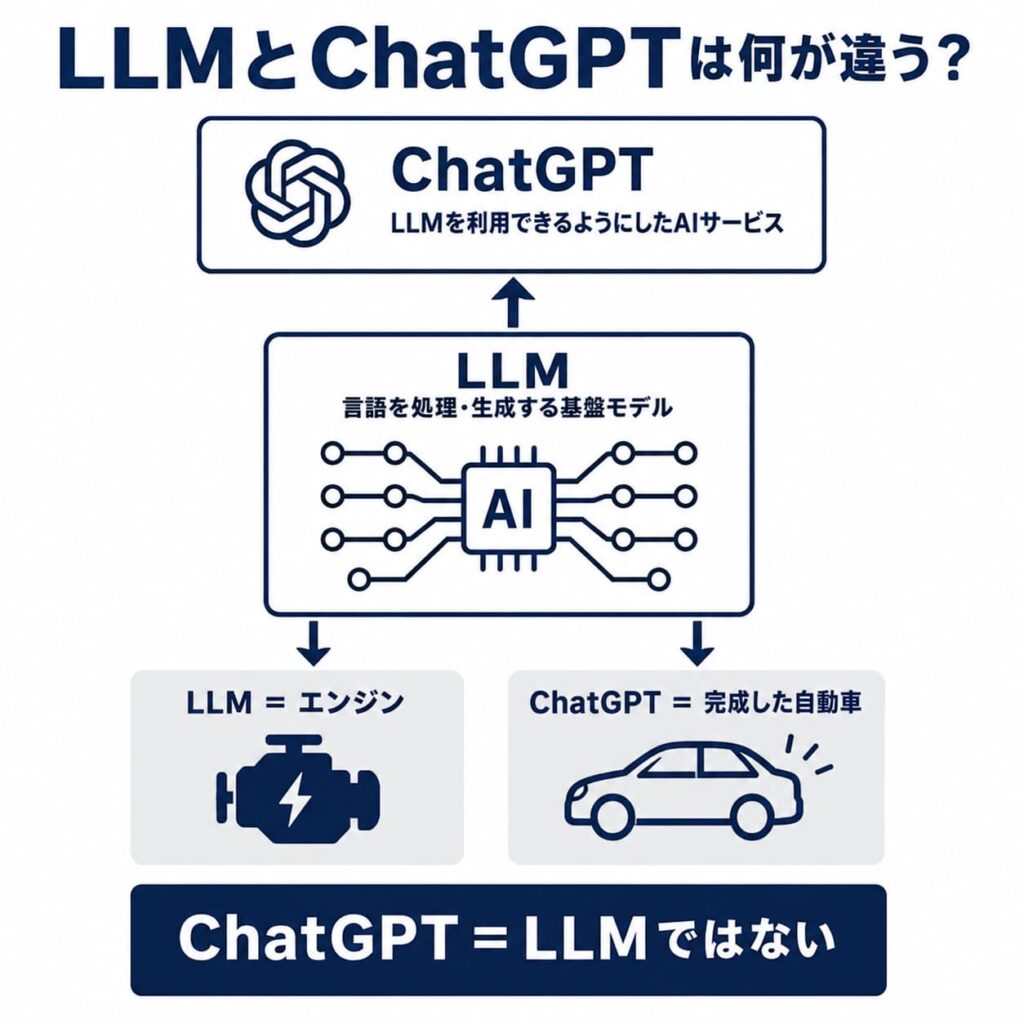
ここは初心者が特に混同しやすいポイントです。
LLMは技術・モデルのカテゴリーであり、ChatGPTはLLMを利用したサービスです。
体で例えるなら、
LLM=言語中枢 ChatGPT=その言語中枢を含む、実際に会話できる体全体(サービス)
に近い関係です。
言語中枢だけでは、一般ユーザーが快適に会話サービスとして利用できません。
インターフェース(会話画面)、記憶の仕組み、各種機能などが組み合わさって、初めて「使えるサービス」になります。
同様にChatGPTも、基盤となるモデルだけではなく、ユーザーインターフェースや各種機能などを組み合わせたサービスとして提供されています。
そのため、
ChatGPT=LLM
ではありません。
代表的なLLMとサービス
現在の生成AI市場には、複数の企業・研究組織が開発するLLMがあります。
代表例としては、
があります。
ここで重要なのは、AIサービス名と、その内部で使われるモデル名を区別することです。
サービス側はモデルを更新したり、用途によって複数モデルを使い分けたりするため、「サービス=1つの固定LLM」とは限りません。
LLMは何ができる?
LLMの用途は文章生成だけではありません。
質問への回答、文章作成、要約、翻訳、情報整理、アイデア出し、プログラミング支援など、言語を中心とした幅広い処理に利用できます。
さらに現在は、画像・音声なども扱うマルチモーダルAIや、LLMが外部ツールを利用してタスクを進めるAIエージェントへと用途が広がっています。
つまりLLMは、生成AIサービスを支える「言語処理エンジン」として多くのシステムに組み込まれています。
LLMは「知識データベース」ではない
ここはLLMを使ううえで非常に重要です。
LLMを、
「インターネット上の正しい情報を全部記憶している巨大データベース」
だと考えると、使い方を誤ります。
LLMは言語パターンを学習したモデルです。
そのため、文章として自然でも、内容が事実とは限りません。
この性質が、いわゆるハルシネーション(Hallucination)につながります。
存在しない論文、間違った数字、架空の人物、誤ったURLなどを、もっともらしく生成することがあります。
したがって医療・法律・金融など正確性が特に重要な分野では、AIの回答だけで判断せず、一次情報を確認する必要があります。
RAGはLLMの弱点をどう補うのか?
そこで登場する技術の一つがRAG(Retrieval-Augmented Generation:検索拡張生成)です。
LLMだけに回答させるのではなく、外部の文書やデータベースから関連情報を取得し、その情報を与えたうえで回答を生成させます。
構造としては、
質問 → 関連情報を検索 → LLMへ検索結果を渡す → 回答を生成
となります。
LLMそのものと、外部情報を検索して利用する仕組みは分けて考えることが重要です。
MCPやAIエージェントとの関係
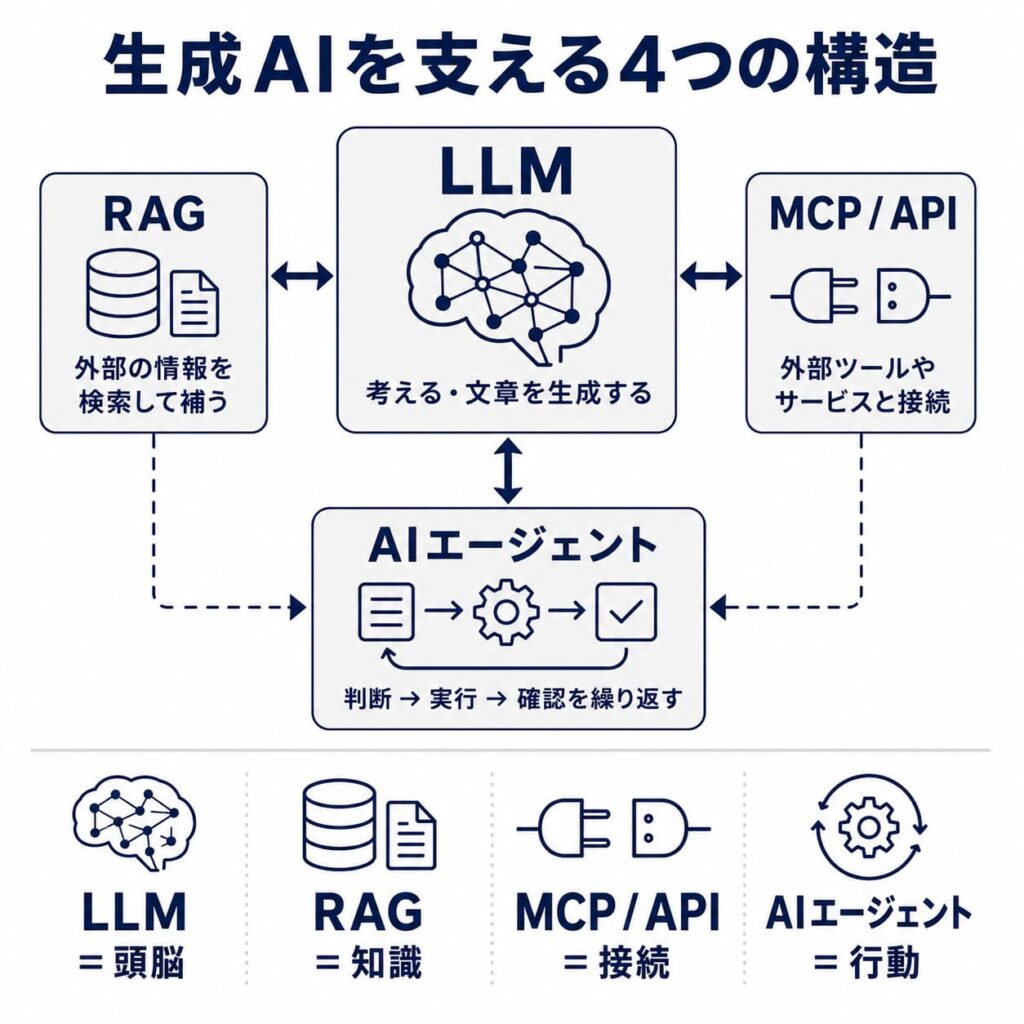
LLMが「言語中枢」だとすれば、外部システムと連携する仕組みは「手足」に近い存在です。
LLM単体では文章を生成できても、それだけであらゆる外部サービスを操作できるわけではありません。
そこでAPIや各種ツール連携、MCPなどを利用して外部システムと接続します。
さらに、
LLMが状況を判断する → 必要なツールを選ぶ → 実行する → 結果を確認する → 次の行動を決める
という方向へ発展したものが、現在注目されるAIエージェントです。
この関係を理解すると、
LLM → RAG → API/MCP → AIエージェント
というAI技術のつながりが見えてきます。
LLMの弱点
LLMは非常に強力ですが、万能ではありません。
最大の問題は、先ほど説明したハルシネーションです。
さらに、学習データや与えられた情報に由来する偏り、入力できる文脈量の制約、計算資源・運用コスト、機密情報やプライバシーの扱いなども考える必要があります。
特にビジネス利用では、
「AIがそう言ったから正しい」
という運用をしないことが重要です。
AI解剖学レビュー|LLMを理解すると生成AIの全体像が見える
LLMという言葉だけを見ると、非常に難しい技術に感じます。
しかし構造を分解すると、本質はかなり理解しやすくなります。
- 文章をトークンへ分解する。
- トークンを数値として処理する。
- Transformerで文脈上の関係を捉える。
- 次のトークンを予測する。
そして、この処理を巨大なモデルで行う。
これがLLMを理解する第一歩です。
ChatGPT、Claude、Geminiなどを単なる「便利なチャットサービス」として見るのではなく、その奥にLLMという基盤が存在すると理解すると、RAG・MCP・AIエージェントといった技術も一本の線につながります。
LLMは、現在の生成AIを理解するための「解剖学」でいう基礎構造にあたる技術です。
よくある質問(FAQ)
Q. LLMとは簡単に言うと何ですか? 大量のデータから言語のパターンを学習し、入力された文脈から続くトークンを予測することで文章などを生成する大規模なAIモデルです。
Q. ChatGPTはLLMですか? 厳密にはChatGPTはLLMそのものではなく、LLMを利用してユーザーと対話できるようにしたAIサービスです。
Q. LLMは文章の意味を理解していますか? 人間とまったく同じ方法で理解している、と考えるのは適切ではありません。LLMはトークンと文脈の関係を数値的に処理し、出力を予測します。
Q. Transformerとは何ですか? 現在のLLMで広く使われるニューラルネットワークのアーキテクチャです。Self-Attentionなどを利用して、文章中の要素同士の関係を処理します。
Q. トークンとは何ですか? AIが文章を処理する際の単位です。1文字、単語の一部、単語全体、句読点などがトークンになることがあります。
Q. LLMは間違えることがありますか? あります。もっともらしい誤情報を生成するハルシネーションなどがあるため、重要な情報では一次情報による確認が必要です。
まとめ
LLM(大規模言語モデル)は、ChatGPTやClaude、Geminiをはじめとする現代の生成AIを理解するうえで欠かせない基盤技術です。
LLMの内部では、文章をトークンとして扱い、Transformerなどを使って文脈を処理しながら、続くトークンを予測して出力を生成します。
一方で、LLMは万能な知識データベースではありません。
ハルシネーションなどの弱点があるため、RAGによる外部情報の取得や、API・MCPによる外部システムとの接続など、別の技術と組み合わせることで実用性が高まります。
生成AIを本当に理解するなら、サービス名を覚えるだけではなく、その中にある構造を理解すること。
その入口となるのがLLMです。
コメント